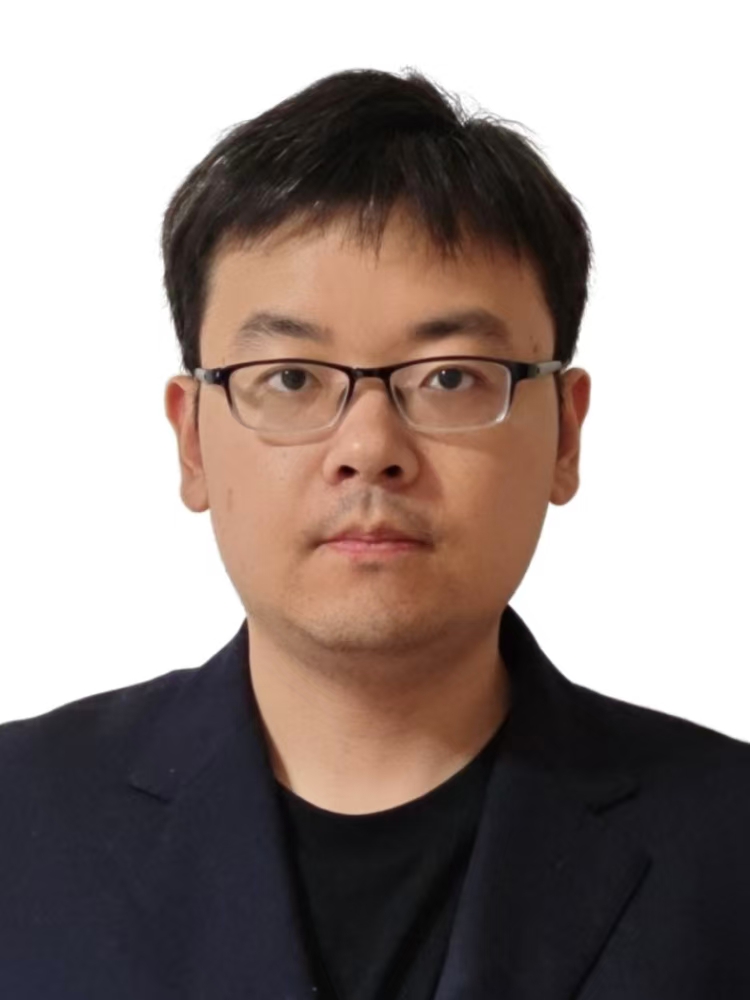
关于我
我是晏梦懿(Mengyi Yan),2017 年于北京航空航天大学数学科学学院获理学学士学位;2025 年 6 月于北京航空航天大学计算机学院(BUAA)取得博士学位,导师为李建欣教授;博士期间在深圳计算科学研究院(SICS)担任研究实习生。2025 年 7 月加入山东大学人工智能学院,现任助理教授。
主要研究兴趣为数据库(Database)、数据质量(Data Quality)、数据清洗(Data Cleaning),以及面向数据库的人工智能(AI4DB)与大语言模型(LLM)的结合。
欢迎通过邮件联系:yanmy@sdu.edu.cn;yanmy1008@buaa.edu.cn;或 yanmy1008@gmail.com。
最新动态
代表性论文
(*:通讯作者)
Mengyi Yan, Dejun Chen, Weilong Ren*, Yutong Ye, Haoyi Zhou, Xiuzhen Cheng,DynaGraph: Holistic Optimization for Latency-Critical GraphRAG Serving via Bidirectional Feedback,ACM SIGMOD International Conference on Management of Data (SIGMOD),2027. 代码
Mengyi Yan, Zhinian Ma, Yue Wang, Yaoshu Wang, Xiaoke Zhu, Zizhe Wang, Haoyi Zhou, Zhumin Chen,When the Bottleneck Shifts: Diagnosing and Closing Information Gaps in Interactive Text-to-SQL,The 2026 Conference on Empirical Methods in Natural Language Processing (EMNLP), Main Conference,2026. 代码
Mengyi Yan, Yaoshu Wang, Guangyi Zhang, Kehan Pang, Haoyi Zhou*,Accelerating Influence Function Estimation for Large Language Models: A Practical Design,ACM SIGKDD Conference on Knowledge Discovery and Data Mining (SIGKDD),2026. 论文 代码
Yang Liu, Mengyi Yan*, Jiao Xue, Weilong Ren, Yutong Ye, Haoyi Zhou, Jianxin Li*, Zhumin Chen,SPARQ: A Cost-Efficient Framework for Offline Table Question Answering via Adaptive Routing,IEEE International Conference on Data Engineering (ICDE),2026. Paper Code
Mengyi Yan, Wenfei Fan, Yaoshu Wang, Min Xie*,Enriching Relations with Additional Attributes for ER,Proceedings of the VLDB Endowment (VLDB),2024. Link
Mengyi Yan, Yaoshu Wang*, Yue Wang, Xiaoye Miao, Jianxin Li,GIDCL: A Graph-Enhanced Interpretable Data Cleaning Framework with Large Language Models,ACM SIGMOD International Conference on Management of Data (SIGMOD),2025. Link Camera-Ready
Mengyi Yan, Yaoshu Wang*, Kehan Pang, Min Xie, Jianxin Li*,Efficient Mixture of Experts based on Large Language Models for Low-Resource Data Preprocessing,ACM SIGKDD Conference on Knowledge Discovery and Data Mining (SIGKDD),2024. Link
Mengyi Yan, Weilong Ren*, Yaoshu Wang, Jianxin Li*,A Retrieval-Augmented Framework for Tabular Interpretation with Large Language Model,Database Systems for Advanced Applications (DASFAA),2024. Link
完整论文列表请参见上方的 Publications 页面。
研究方向
我的研究聚焦于数据库、数据质量、数据清洗,以及面向数据库的人工智能(AI4DB)与大语言模型(LLM)的结合,相关成果发表于 SIGMOD、VLDB、KDD、DASFAA、EMNLP 等会议。下面对几个主要方向作简要介绍。
面向数据驱动 AI 的低成本数据预处理与推理
我致力于在大语言模型之上构建数据与算力双高效的处理流水线:通过最小化标注与计算开销(在消费级硬件上即可运行离线 LLM),在多种数据预处理与表格推理场景下取得与在线模型相当的效果,覆盖实体解析(Entity Resolution)、表格表示学习(Tabular Representation Learning)、关系抽取(Relation Extraction)与表格问答(Table Question Answering)等任务。相关成果发表于 [SIGMOD’27、EMNLP’26、ICDE’26、KDD’24、DASFAA’24、BigData’24 与 EMNLP’25]。
数据清洗
我研究如何借助知识增强的方法(如基于 LLM 的智能体、知识图谱)提升数据清洗系统的性能,相关成果发表于 [SIGMOD’25、SIGMOD’24、VLDB’24]。
面向大语言模型的数据评估、影响估计与合成
我研究如何评估并优化用于训练大语言模型(LLM)的数据:综合运用不确定性量化(Uncertainty Quantification)、影响函数(Influence Function)、次模优化(Submodular Optimization)等工具,在预训练、微调以及特定领域适配等阶段衡量数据的冗余度与价值。其中一个重点是让影响函数式的训练数据归因在现代 LLM 上变得可扩展、可落地,从而指导各类下游任务的训练数据组合,最大化模型表现与训练效率。相关成果发表于 [KDD’26、FCS’25、AIJ’23 与 arXiv]。
学术报告
MELD: Efficient Mixture of Experts based on LLM for Low-Resource Data Preprocessing
- KDD 2024 大会,2024 年 8 月,西班牙 巴塞罗那
同行评审
KDD、NIPS/NeurIPS、ICLR、AAAI、ICDE 等会议外审。
承担课程
本科生课程:数据库系统;研究生课程:深度学习。